2026-09-28
梅西世界杯8次主罚点球4次罚失,成为世界杯“点球失意之王”,但他仍是足球史上进球最多的球员之一,其坚韧精神令人敬佩。 ... [详细]

遵守相关法律法规、删帖联系底部客服
|
徽声在线科技前沿报道 谷歌,或许已成功突破RSI技术瓶颈! 近日,谷歌联合Google DeepMind、马里兰大学及弗吉尼亚大学的研究团队,在权威学术平台发布了一项突破性研究成果。 该研究提出了一种颠覆性的RSI实现路径:AI通过「梦境模拟」实现自我进化,这一发现或将重塑人工智能发展范式。 研究团队创新性地将智能体的探索过程构建为树状结构,通过在记忆树中进行虚拟推演完成策略优化。 这种「梦境训练」模式使AI能够在虚拟环境中预演策略效果,再将优化后的方案应用于现实场景。 <论文完整版:https://arxiv.org/abs/2609.14858 Dream-RSI技术展现惊人效能: 在算法优化任务中,传统进化系统需运行51200代才能达到的优化水平,Dream-RSI仅需317次调用即可实现同等效果。 在圆填充问题挑战中,该技术追平了谷歌AlphaEvolveV2系统保持的全球最优纪录。 GPU内核优化测试显示,在保持同等性能的前提下,代码生成次数大幅减少2.43倍。 更值得关注的是,该技术可直接应用于Gemini 3.1 Pro和3.7 Flash等现有模型架构,无需修改底层权重参数。 研究还揭示了一个反直觉现象:人类干预反而会降低AI的探索效率。 论文发布后立即引发学界震动,X平台科技博主Mark Kretschmann激动表示:「这可能是递归自我改进技术的重大突破!」 论文核心作者Tong Zheng现为马里兰大学二年级博士生,今年夏季以访问研究员身份加入谷歌。该研究团队由17位跨学科专家组成,其中包括DeepMind资深研究员和知名高校讲席教授。 实现递归自我改进的关键,在于构建AI的「梦境世界」。正如Tong Zheng在技术社区所言: 「历史数据,就是AI进化的虚拟训练场」 破解进化搜索领域的核心难题 以AlphaEvolve为代表的现有系统虽能发现人类未掌握的算法,但存在致命缺陷:探索策略完全依赖人工预设。当搜索空间复杂度提升时,固定策略会导致计算资源浪费,且无法从失败中学习优化。 传统策略进化面临评估成本困境:验证单个代码片段只需单次运行,而评估探索策略需要完整执行数百轮搜索过程。每次策略调整都需重新运行整个流程,导致优化周期长达数天。 Dream-RSI的解决方案是建立「经验回放机制」,将历史探索过程结构化存储为「发现树」。评估新策略时,系统直接在虚拟树中进行回放推演,无需重复执行实际代码。 该架构采用双层设计: - 执行层:由Gemini 3.1 Pro/3.7 Flash驱动的「发现智能体」,负责代码生成与执行 - 策略层:轻量化Python代码构成的「探索策略」,控制搜索路径选择、并行度调整等决策 这种分离设计使策略优化独立于底层模型,显著降低进化成本。 每次真实探索都会生成新的「发现树」节点,包含文件系统快照、生成产物、评估数据等完整信息。这棵树状结构即成为AI的「梦境模拟器」。策略优化时,系统通过遍历树节点预演不同决策路径的效果。 策略决策范围仅限于路径选择和并行度控制,而每个节点的具体结果已预先记录在树中。这种设计使策略评估完全基于历史数据,无需实际代码执行。 正如棋手复盘无需重新对弈,AI通过分析历史棋谱即可优化策略。这种机制使策略评估效率提升数个数量级。 Dream-RSI技术闭环解析 基于上述原理,研究团队构建了完整的自我进化系统,其运行周期包含三个阶段: 1. 真实探索阶段:当前策略引导智能体在真实环境中执行任务,所有探索路径、决策记录和执行反馈被结构化存储为新的树节点,持续扩充历史数据库。 2. 模拟器构建阶段:将更新后的历史数据库转化为可重用的「回放模拟器池」,为策略优化提供虚拟训练环境。 3. 策略进化阶段:专门的策略开发智能体在模拟器中进行「梦境训练」,通过修改策略代码生成候选方案,并在虚拟环境中快速验证效果。 策略评估采用复合指标:包含最优解质量、计算成本消耗和并行效率奖励。得分最高的策略将作为新一代方案投入实际应用。 这种设计确保新策略在保持探索效率的同时,持续优化搜索质量。 策略优化工作由独立的「策略开发智能体」执行,其决策依据包含三个方面:当前策略的模拟执行轨迹、历史版本优化反馈、完整发现树结构。基于这些信息,系统直接修改策略代码生成改进版本。 每个候选策略都在模拟器中接受快速验证,得分最优者成为新一代策略。这种机制确保策略性能持续提升,理论上具有无限进化潜力。 RSI技术飞轮由此形成闭环运转。 技术保障:策略性能永不退化 在离线优化阶段,策略开发智能体进行多轮代码迭代。由于候选池中始终包含当前策略版本,只有综合得分(平衡探索质量、计算成本和并行效率)更高的新策略才会被采用。这种设计从数学层面确保: 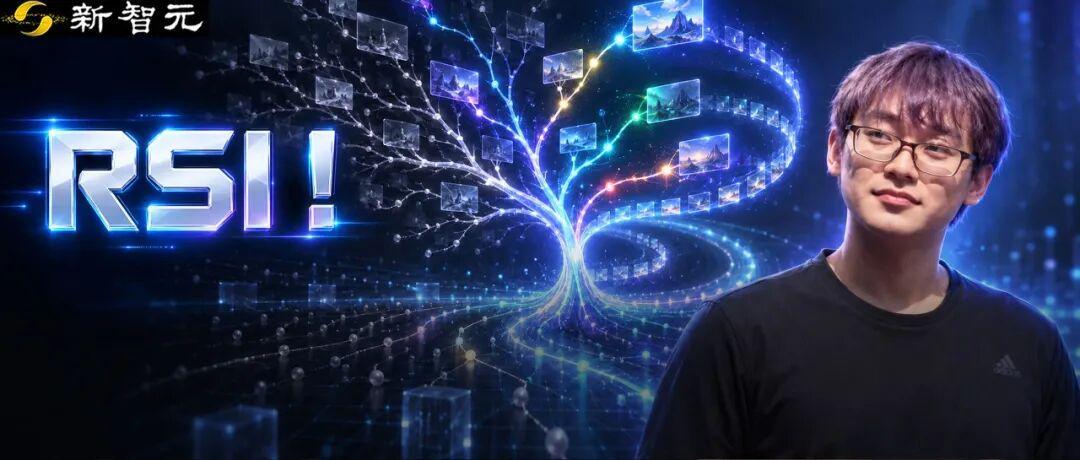 新一代策略性能绝不会弱于前代版本。随着真实探索的持续进行,系统积累更丰富的历史数据,推动模拟器不断进化,形成智能体与虚拟环境的协同成长。 这种共生关系使AI的探索能力呈现指数级提升。 策略优化与算法发现的良性循环:历史数据丰富度提升梦境模拟精度,梦境精度提高促进策略进化,进化后的策略又带来更深入的真实探索。系统始终在未知领域保持有效扩展。 初始策略采用简单并行探索模式,随着进化推进逐渐掌握智能资源分配。在ConvDiv内核实验中,系统在性能提升期主动减少单轮尝试次数,当性能停滞时立即加大探索力度,这种动态调整完全基于历史数据自学而成。 实测数据:317次调用碾压5万代进化 研究团队在三个领域进行了严格验证: 1. 算法工程领域:Lasso正则化路径求解器优化 在高维统计计算难题中,Gemini 3.1 Pro驱动的Dream-RSI仅需317次调用,就将求解器平均运行时间从3587.1毫秒压缩至2931.0毫秒。相比之下: - 固定策略需要550次调用达到同等效果 - SimpleTES基线系统需生成51200次才能接近该性能 <- 使用更轻量的Gemini 3.7 Flash时,1879次调用即可将运行时间降至2350.6毫秒 该成果证明,进化发生在策略层面而非模型底层时,小规模模型同样能获得显著提升。 Dream-RSI发现的求解方案突破传统框架,将自适应机制嵌入活跃集优化过程:先通过强规则筛选特征,再利用柯西-施瓦茨不等式进行KKT剪枝,仅在必要时计算精确梯度。这种创新设计显著提升计算效率。 2. 数学优化领域:三大高难度问题突破 在「和差问题」、「圆装填」和「自相关不等式」等极耗算力的几何优化挑战中,Dream-RSI在1000代内即达到或超越强基线性能。 与需要51200代计算的SimpleTES相比,该技术节省超过98%的计算资源,同时获得更优解。在圆装填问题中,系统追平了AlphaEvolveV2保持的全球最优纪录。 3. GPU算子工程:KernelBench性能突破 在GPU内核优化测试中,系统对四种典型内核进行极限压榨: - VGG16和LayerNorm内核:达到同等性能时,Dream-RSI的生成次数仅为基线系统的1/2.43和1/1.79 - ConvDiv和ConvMax内核:在相同预算下,优化后内核性能分别达到基线系统的2.09倍和1.44倍 研究团队尝试将历史轨迹转化为方向性提示输入系统,试图引导探索方向。但实验结果显示:在相同计算预算下,人类指导的探索效果始终劣于自主探索。 深度解析:人类经验为何适得其反? 实验揭示了一个颠覆性现象:将历史经验抽象为高层指导原则,反而会降低AI的探索效能。这种「经验诅咒」现象源于: - 高层抽象转化为认知偏见,限制搜索空间范围 - 预设指导原则扼杀探索多样性,导致系统陷入局部最优解 相比之下,Dream-RSI的「梦境训练」机制直接操作具体历史数据,在并行控制、分支优先级等微观层面进行代码级优化。这种保持探索空间开放性的设计,反而获得更优效果。 青年学者领衔:暑期实习生的科研突破 17人豪华团队护航创新 论文第一作者Tong Zheng(郑童)2021年毕业于东北大学,本科期间即在国内顶尖机器翻译团队(肖桐组)开展研究。2024年进入马里兰大学攻读博士学位,师从黄恒教授。这项突破性成果诞生于他在谷歌的暑期研究项目。 郑童的研究轨迹始终聚焦「防止模型陷入局部最优」:从ICLR 2025的投机解码技术,到ICLR 2026/ICML 2026的并行思考框架,其研究持续探索模型思维的多元化路径。Dream-RSI中的并行奖励机制,正是这种研究理念的延续与发展。 导师黄恒教授作为马里兰大学Brendan Iribe讲席教授,已发表约300篇顶会论文,主持7个NSF项目和3个NIH项目。其团队近年专注于大模型推理优化研究,为Dream-RSI提供了坚实的理论支撑。 17人作者团队中,通讯作者Xidong Wu和Zheng Zhang来自谷歌核心部门,DeepMind一侧包含推荐系统领域知名学者Wang-Cheng Kang(SASRec作者)。这种跨机构协作阵容,彰显谷歌对该技术路线的高度重视。 技术革命前夜:通往ASI的隐秘通道? 谷歌产品负责人Logan Kilpatrick此前透露:公司正全力追踪RSI技术进展,并已观察到早期技术迹象。他以Gemini系列模型的快速迭代为例:从3.5到3.8版本约每三周更新一次,暗示技术突破可能带来的研发加速。 Logan强调,谷歌将集中资源投入代码生成、科学研究和基础研究领域,因为这些方向最可能实现训练成本指数级下降。这种战略布局与Dream-RSI的技术理念高度契合。 RSI技术范式的转变正在重塑行业认知:传统观念认为AI进化必须通过修改自身权重实现,但Dream-RSI展示了另一种可能——通过优化外围控制策略,同样能实现能力跃迁。这种「四两拨千斤」的进化模式,可能成为突破算力瓶颈的关键。 正如论文结论所言: 「递归自我改进需要AI学会做梦,而历史数据就是构建梦境的完整世界」 随着Gemini 4等超大规模模型的临近,这种「在虚拟历史中进化」的技术路径,或许正在为智能爆发创造临界条件。我们可能正站在新一轮AI革命的起点上。 参考资料: 编辑:摩西 Aeneas |
 宁德时代豪掷14亿,雅安新建4万吨碳酸锂年产能项目公示
 宁德时代豪掷14亿雅安建4万吨碳酸锂基地,强化供应链布局
 “奕境模式堪称完美!”曾清林谈华为与车企合作:每家企业路径不同,华为是难得战略伙伴
 OpenAI新发现:AI正在重塑职场边界 跨界工作成新常态? 宁德时代豪掷14亿,雅安新建4万吨碳酸锂年产能项目公示 宁德时代豪掷14亿雅安建4万吨碳酸锂基地,强化供应链布局 “奕境模式堪称完美!”曾清林谈华为与车企合作:每家企业路径不同,华为是难得战略伙伴 OpenAI新发现:AI正在重塑职场边界 跨界工作成新常态?
 影视飓风实测iPhone Duo高温问题 苹果回应称个体测试存局限
 何小鹏揭秘慕尼黑全英文演讲幕后:竟是公关团队的"甜蜜陷阱"
 iPhone Duo微信功能引争议,客服回应适配问题待解
 iPhone Duo暂未支持微信平板模式?苹果官方回应来了
 影视飓风Tim反掰iPhoneDuo闪屏引争议 李楠质疑流量动机 苹果客服明确保修政策

2026-09-28
梅西世界杯8次主罚点球4次罚失,成为世界杯“点球失意之王”,但他仍是足球史上进球最多的球员之一,其坚韧精神令人敬佩。 ... [详细]
2026-09-28
谷歌联合研究团队提出Dream-RSI技术,通过构建AI梦境模拟器实现策略自我进化。实验显示该技术在算法优化、数学难题和GPU内核设计等领域取得突破性进展,性能提升最高达209%,计算成本降低98%。这项成果可能重塑人工智能发展路径。 ... [详细]


2026-09-28
2026年世界杯四分之一决赛,梅西罕见与裁判发生冲突,背后原因涉及比赛压力、裁判背景及个人原则。冲突过后,梅西用行动证明权威不等于不尊重,引发球迷对相互尊重的讨论。 ... [详细]

2026-09-28
梅西在赛后采访中直言不愿今天就结束行程回家,这句话背后隐藏着对失败的抗拒、对国家队生涯的眷恋,以及全队共同的不甘与决心。 ... [详细]
啥病人看了这个都得好啊! 副标题 这胸是真的! 副标题 你赢了! 副标题 我是关心这是在哪里
乞丐装的最新境界! 副标题 买家你确定你不是阿宝?? 副标题 这裤子不敢坐下啊! 副标题 颜值
这鼠标垫你看到了什么?邪恶了吧! 副标题 毫无违和感! 副标题 小卖部的这女孩真会选呀! 副
女人真的不容易,怀孕后,内脏被挤压的严重,挺着大肚子干啥都不方便!近日,刘嘉姵和闺蜜集体拍
锤哥的替身也是辣么的帅气! 副标题 锤哥的替身好多啊! 副标题 你杀了你的替身,你可就没替
关于舌钉,一定是从欧美流传过来的朋克风,很多人喜欢在脸上、身上穿各种环,打各种钉,可能是
折耳根是一种在南方很常见的植物,北方人可能很少人知道折耳根是什么。下面就让我们先来
说到卢森堡这个国家,大家都知道这是一个比较小的国家,但是卢森堡的经济是相当的发达的,可


